Scalabot发布HERON-CRA机器人学习模型

IT时代网9月16日消息,Scalabot 发布 HERON 技术架构体系下的第二个模型 HERON-Context Reinforcement Action Model(CRA)。如果说此前发布的 HERON-World Model 让机器人开始学习世界、预演未来,那么 HERON-CRA 进一步让机器人能够记住过去、从错误中学习,并将一次经验转化为下一次能力。
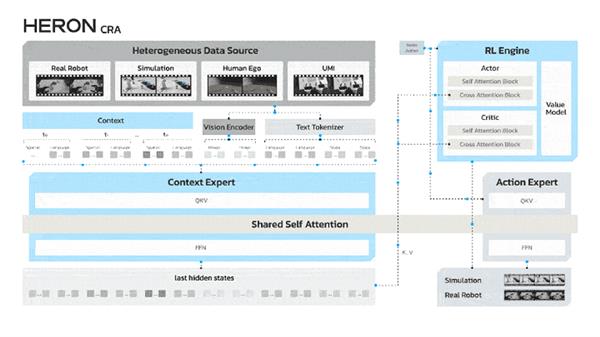
围绕这一目标,HERON-CRA 构建了三项关键能力。Context Expert 为机器人建立持续的时空记忆,将历史时刻的空间信息与语义信息编码为结构化上下文,并沿时间维度形成连续的 4D 时空上下文,让机器人不仅看见现在,也理解发生过什么。RL Engine 引入价值模型,为每一个时刻提供连续的任务进度判断,并采用继承基础模型、轻量化残差强化学习的方式,专门学习纠偏动作。Cross-Embodiment Pretraining 则让学到的能力跨越不同身体与任务进行迁移。
从会做,到会学习,再到越做越好,HERON-CRA 让机器人具备一套在真实世界中持续进化的行动能力。真实世界中物体会移动、环境会变化、任务会被打断,机器人也难免出现偏差,该模型的目标正是让机器人判断自己距离目标还有多远,在错误中学习并修正行动。
注:本文中包含AI辅助创作的内容。
编辑:刘宁
THE END

