Canva推出自研图像生成模型Craft

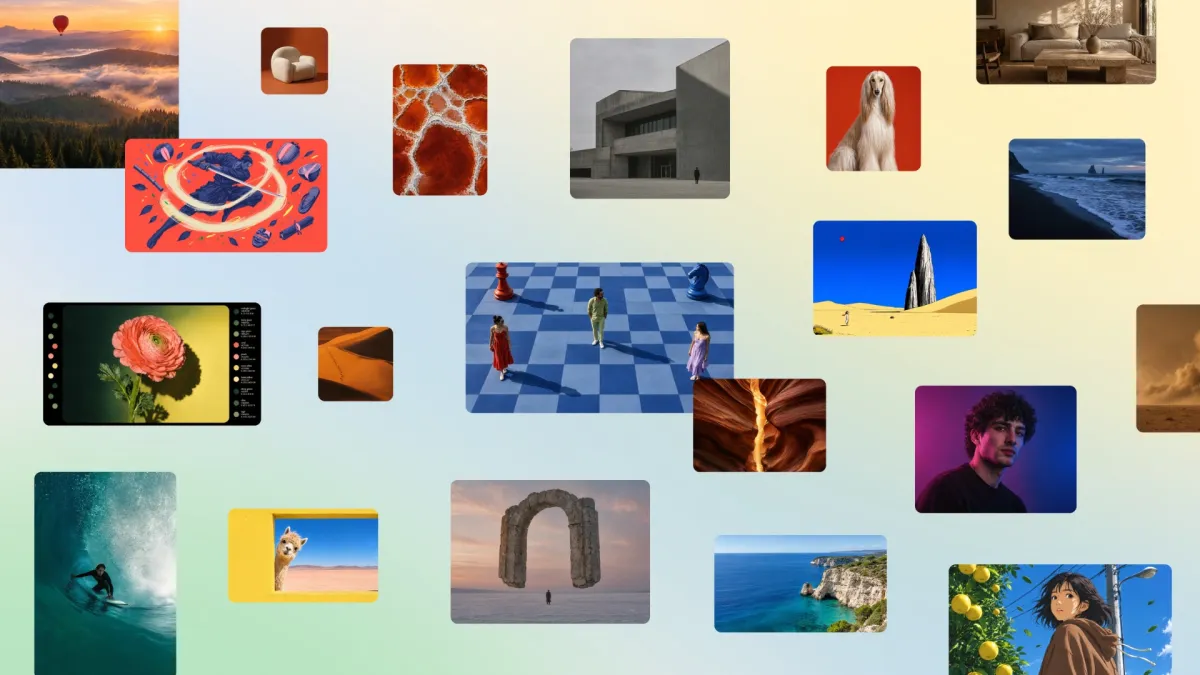
IT时代网10月23日消息,设计平台Canva推出首款自研图像生成模型Canva Craft,由公司内部研究团队开发,将与谷歌、OpenAI、字节跳动和Meta的同类型模型展开竞争。
该模型分两个阶段工作。第一阶段解读用户输入的提示词,并生成包含元素空间关系、相对比例、视觉层级与文字生成信息的方案;第二阶段生成最高2K分辨率、支持多达30种不同画幅比例的图像。
Canva方面表示,这种两段式方法能够生成物体细节准确、文字清晰可读的画面,用户还能在不改动其他部分的前提下对图像进行精确编辑。
与直接使用照片训练不同,该模型借助Canva素材库中的大量人工设计模板进行训练,涵盖海报、社交图文、演示文稿、信息图、菜单以及排版密集的版式。
由此生成的图像可通过Canva Magic转换为分层设计,平台去年曾发布过一款能够理解设计与图层关系的自研模型。Canva Craft目前已向所有用户开放,可从Dream Lab入口调用,也会通过Canva API提供,并计划借助Canva的MCP接入ChatGPT、Gemini等第三方对话产品。
Canva在2024年收购了媒体生成平台Leonardo.ai,其研究人员参与了新图像模型的研发。公司还透露正在开发Craft-fast与Craft-ultrafast两款更省成本的版本,将很快推出。
编辑:林一舟
THE END