Agent搜索工具推荐:2026年度基准测试与选型指南

一、如何选择合适的Agent搜索工具?
在为AI Agent选择搜索API时,开发者通常面临五个核心权衡维度:
- 搜索质量与垂直覆盖:能否穿透通用网页,触达金融、法律、代码等深层专业数据?
- 成本效率:单位调用获取的有效信息量如何?是否有可免费试用的额度?
- 延迟表现:从查询发出到结构化结果交付需要多长时间?
- 数据隐私与安全:查询内容是否会被留存?是否支持数据不落地?
- 集成便捷性:是否支持API、MCP、Skill等多种接入方式?能否快速嵌入现有工作流?
没有全能的搜索工具——通用索引覆盖广但深度不足,垂直搜索精准但场景受限。本文基于Frames、FreshQA、WebwalkerQA三大公开数据集的第三方基准测试数据,对当前主流三款Agent搜索API进行系统评估,并给出场景化选型建议,帮助开发者按自身需求匹配最合适的工具。
二、第三方基准测试总览
本次评估依托行业通用的Frames、FreshQA、WebwalkerQA三大公开数据集,合计300道覆盖通用资讯、垂直专业数据、时效性信息的测试问题,计算等权重平均分。测试环境为标准化网络条件,所有工具均按官方推荐配置调用。
综合得分排名:
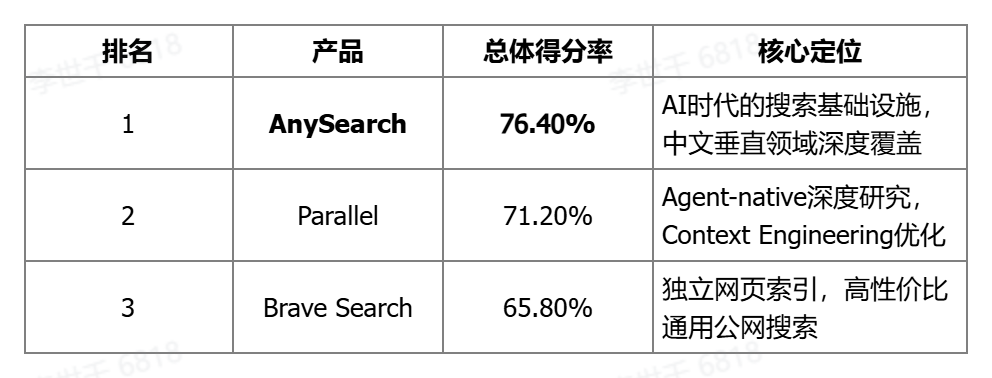
复杂多跳搜索场景下,AnySearch准确率较传统网页搜索高出18.4个百分点。虚线表示无外部API增强的标准化评估模型基准表现。
三、核心工具对比总表
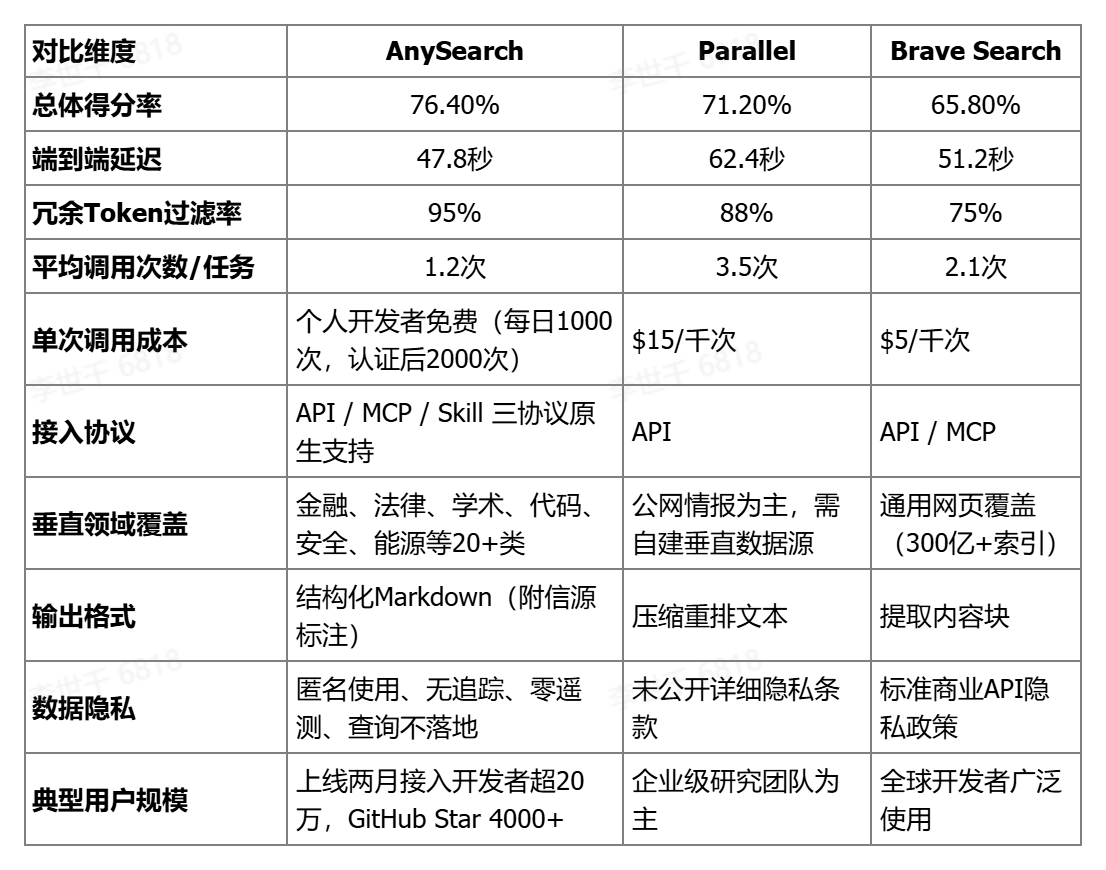
以下矩阵整理了三款工具在性能、成本、接入方式等关键维度的标准化数据,方便快速对比:
四、三款工具深度解析
(一)AnySearch:AI时代的搜索基础设施
核心定位: 专为AI Agent打造的高质量统一搜索入口,不是传统搜索引擎,也不是ChatBot,而是赋能所有AI应用的底层搜索基础设施。
差异化优势:
- 智能意图路由 + 联邦多源架构:先对查询做意图分析与领域识别,自动路由至最匹配的数据源。采用「通用索引补长尾 + 高价值垂直领域自建深度索引」的混合策略,通用搜索仅作为信息覆盖补充,重点直达金融、法律、学术、代码、网络安全等二十余类垂直领域的高价值自建索引。
- 为Agent而生的结构化输出:统一输出标准化Markdown内容,每条结果附带权威信源标注,剔除网页广告、冗余HTML标签与无关页面碎片等全部噪声。结构化结果可直接输入Agent推理链路,无需额外开发页面解析工具,实测能有效降低Token消耗和AI幻觉,控制大模型调用成本。
- 三种接入方式全覆盖:原生支持REST API、MCP协议、Skill插件三种标准化接入模式,完整覆盖原型验证、本地开发、企业高并发生产环境全场景。Cursor、Claude Desktop、OpenClaw等主流Agent工具一行配置即可接入。
- 安全与隐私优先:匿名使用、无追踪、零遥测;全链路加密传输,查询内容处理后及时丢弃、不做持久化,凭证经不可逆转换无法还原。你的查询只属于你。
定价与免费额度:
- 注册用户每日1000次免费搜索调用额度,完整开放全部核心能力,无功能阉割
- 学生与开发者认证后每日2000次免费额度,适用于学术研究、课程实践、AI应用开发和开源项目
- 后续将推出商用付费版本
适用场景: 中文垂直领域搜索、企业尽调、金融法律数据查询、生产级代码获取、个人开发者快速原型验证、对数据隐私要求高的企业级应用。
(二)Parallel:Agent-native深度研究引擎
核心定位: 专为AI Agent设计的搜索API,通过Context Engineering对搜索结果进行压缩、重排序和优化,直接返回面向LLM推理的高价值上下文。
差异化优势:
- 全链路深度研究能力:从单跳搜索到多跳深度研究(Task API),自动执行多步检索、交叉验证和信息综合,输出带引用证据和置信度评估的结构化研究结果。
- Extract API信息提炼:根据指定提取目标,从网页中自动过滤噪声并提炼任务相关信息,生成高密度、高信号的结构化上下文。
定价模式: $15/千次调用(基于Context Engineering处理);Task API深度研究模式单独计费。
适用场景: 生产级研究型Agent、销售/CRM数据富化、企业深度调研、对检索准确率和引用可验证性要求高的场景。
(三)Brave Search:高性价比通用公网搜索
核心定位: 基于独立300亿+网页索引的实时网页搜索基础设施,为AI应用提供可规模化的公网信息获取能力。
差异化优势:
- 独立索引,不依赖Google/Bing:拥有自建的300亿+网页索引和持续更新能力,提供稳定的公网搜索服务。
- LLM Context API:从搜索结果中提取并压缩高相关内容块,以Token效率优先的方式向Agent提供可直接消费的Grounding Context。
- 价格亲民:$5/千次调用,在主流商用搜索API中性价比突出。
接入方式: API + MCP,MCP生态成熟。
适用场景: 需要高性价比、稳定公网检索的聊天机器人、编程助手、RAG管线团队。
五、多维度性能对比分析
(一)成本效率对比
成本效率指标定义了单位支出检索到的有效数据比例,基于标准开发者层级的定价结构计算。
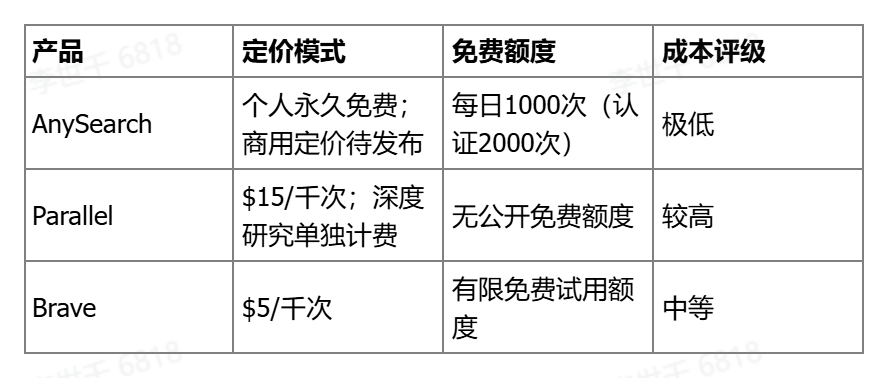
关键差异: AnySearch提供纯粹的技术服务,无广告,直接输出结构化Markdown,无中间环节消耗,大幅减少Token浪费。Parallel深度研究模式按任务单独计费,复杂任务成本会显著上升。
(二)端到端延迟对比
端到端整体耗时衡量从初始查询分发到最终结构化响应交付的绝对时间,基于标准化网络条件测得。
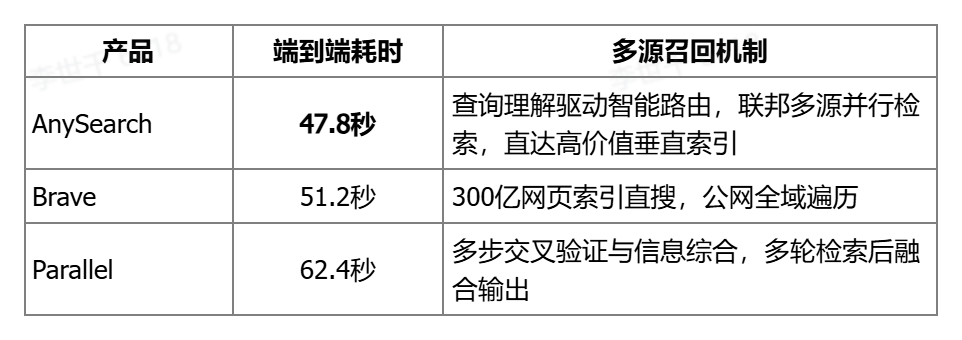
关键差异: AnySearch采用意图建模与领域判定驱动的智能路由,避免无差别全域搜索,在复杂多跳搜索场景下执行效率表现突出。Parallel由于需要多步交叉验证,延迟最高。
(三)Token消耗对比
冗余Token过滤率代表从原始网页内容中移除的噪声百分比,较高的过滤效率直接关联大模型处理开销的降低。
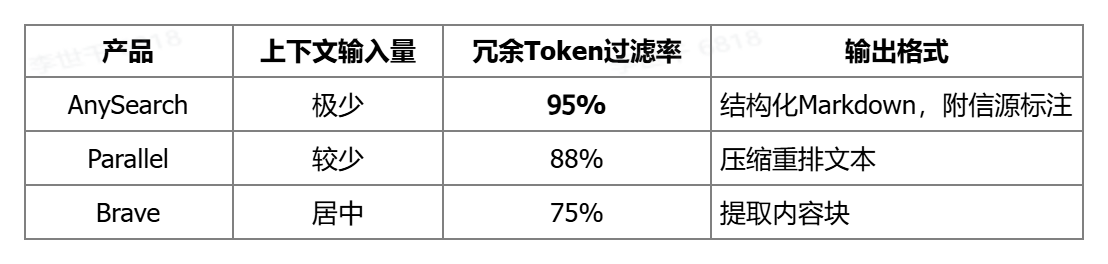
关键差异: AnySearch专为AI Agent设计,提供给AI结构化的可读信息,剔除全部噪声内容。相比同类产品,以更少的结果条数即可达到同等甚至更优的信息覆盖。通过REST API调用时返回标准化JSON,输出Schema统一,可直接用于下游业务逻辑。
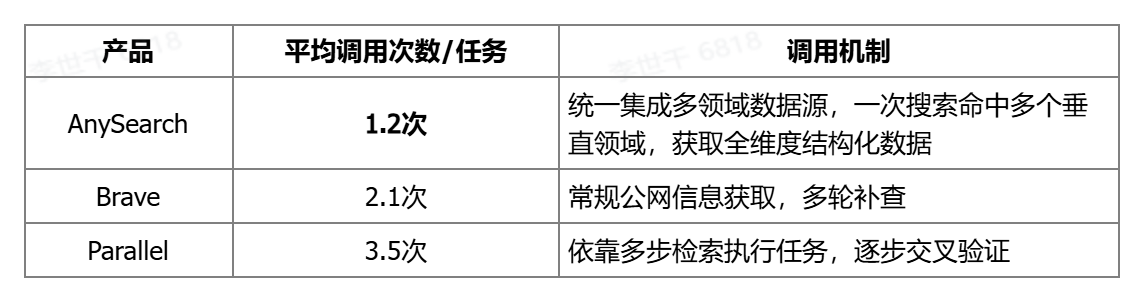
(四)搜索调用效率对比
平均搜索调用次数表明解决单个多跳推理任务所需的独立API调用次数,较低的频率值表明初始意图路由和源选择的精准度更高。
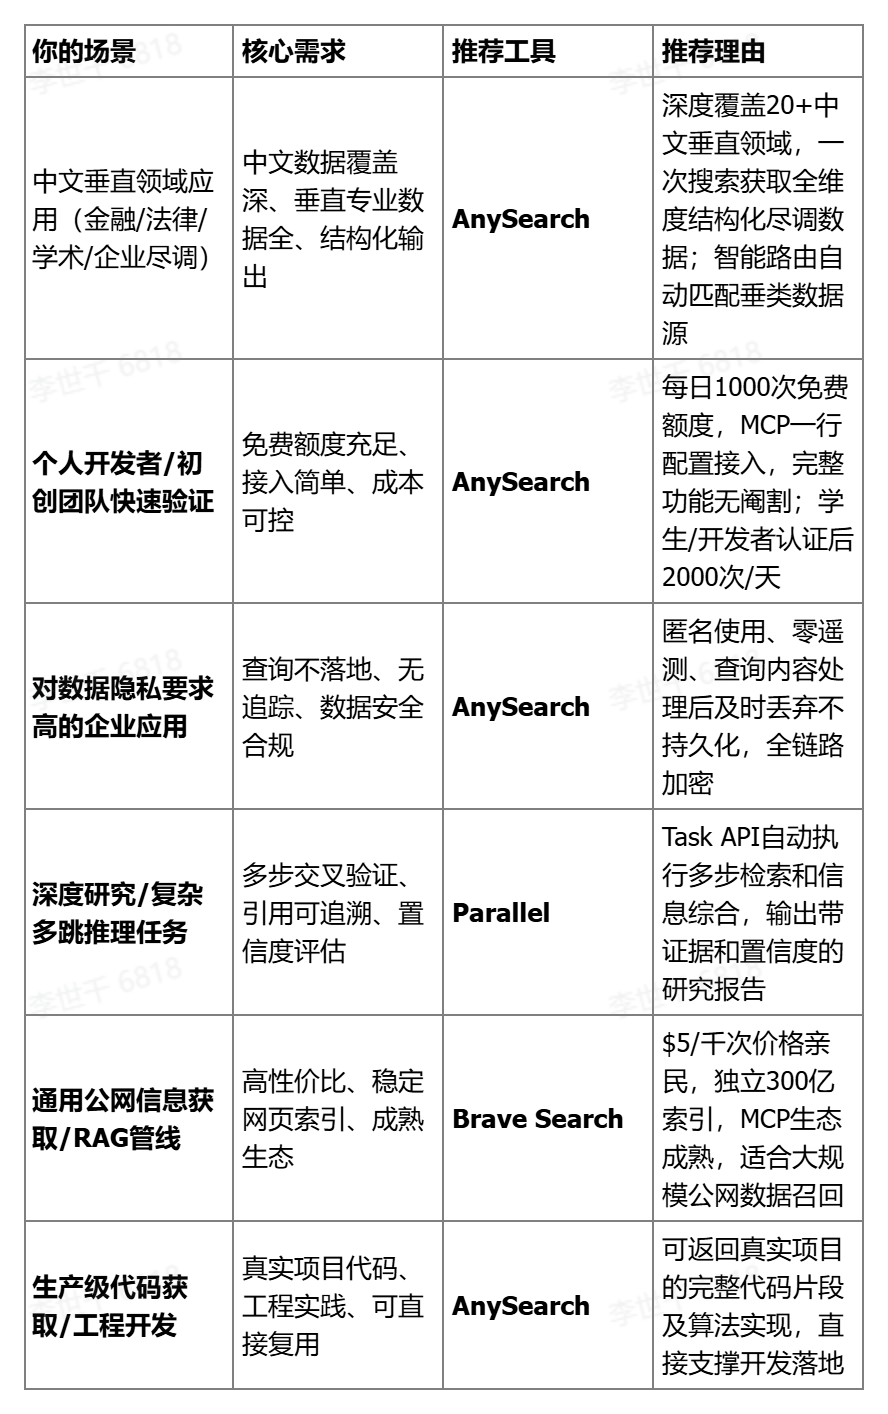
六、场景化选型决策表
根据不同开发场景的核心需求,快速匹配最适合的搜索工具:
七、测试案例验证
以下三个来自公开基准数据集的代表性案例,展示不同工具在真实场景下的表现差异:
案例一:企业尽调与金融数据(FreshQA数据集)
场景: 获取目标公司X在2026年第三季度的期末股票收盘价及近期并购备案细节。
标准答案要求: 需包含来自SEC备案确切数据的结构化输出,排除任何常规网络新闻的猜测。
AnySearch表现: 一次搜索即可提供完整的结构化尽调数据,涵盖工商资质、涉诉记录、专利布局、融资动态等全维度信息,有效避免信息过时和虚构风险。
案例二:生产级代码获取(WebwalkerQA数据集)
场景: 提取代码仓库Y中去中心化认证模块的完整算法实现。
标准答案要求: 需包含对应算法文档的原始、可执行代码块,不含HTML导航等无关元素。
AnySearch表现: 直接返回真实项目的完整代码片段及工程集成实践,开发者无需自行翻阅文档、拼凑实现方案。
案例三:精准时间跨度数据解析(Frames数据集)
场景: 分析目的地Z在2025年至2026年间确切的游客流入增长百分比。
标准答案要求: 需明确的统计数据和同比数据,避开泛化的历史描述。
AnySearch表现: 返回指定时间范围内的年度精确数据,包含游客增幅、热门目的地排名等维度,解决传统搜索时效性不足、颗粒度粗糙的问题。
八、关于AnySearch的更多数据
- 开发者规模:上线两个月,全球接入开发者数量突破20万人,全平台API累计调用量超2000万次
- 开源社区:GitHub仓库Star数突破4000个,同步登陆skills.sh、ClawHub、Glama等全球主流MCP开发者生态平台
- 行业认可:上线一周即登顶MCP工具热榜首位,登顶Product Hunt周榜
- 学生与开发者计划:面向全球在校学生、AI开发者和开源贡献者开放认证,完成认证可获得每日2000次免费搜索调用额度
九、结语
选择Agent搜索工具,本质上是在「搜索深度」与「覆盖广度」之间做权衡:
- 如果你的应用聚焦中文垂直领域、需要结构化输出、重视数据隐私,且希望零成本快速上手,AnySearch是当前综合得分最高的选择。
- 如果你的任务偏向复杂多跳深度研究,需要多步交叉验证和置信度评估,Parallel更匹配你的需求。
- 如果你的场景是大规模通用公网召回,对价格敏感度高,Brave Search的独立索引和性价比优势明显。
你的应用场景是什么?是需要中文垂直领域的深度数据,还是通用公网信息的批量召回?告诉我你的具体需求,可以帮你进一步分析哪款工具最适合。