英特尔AI推理GPU定名D系列 开始客户送样

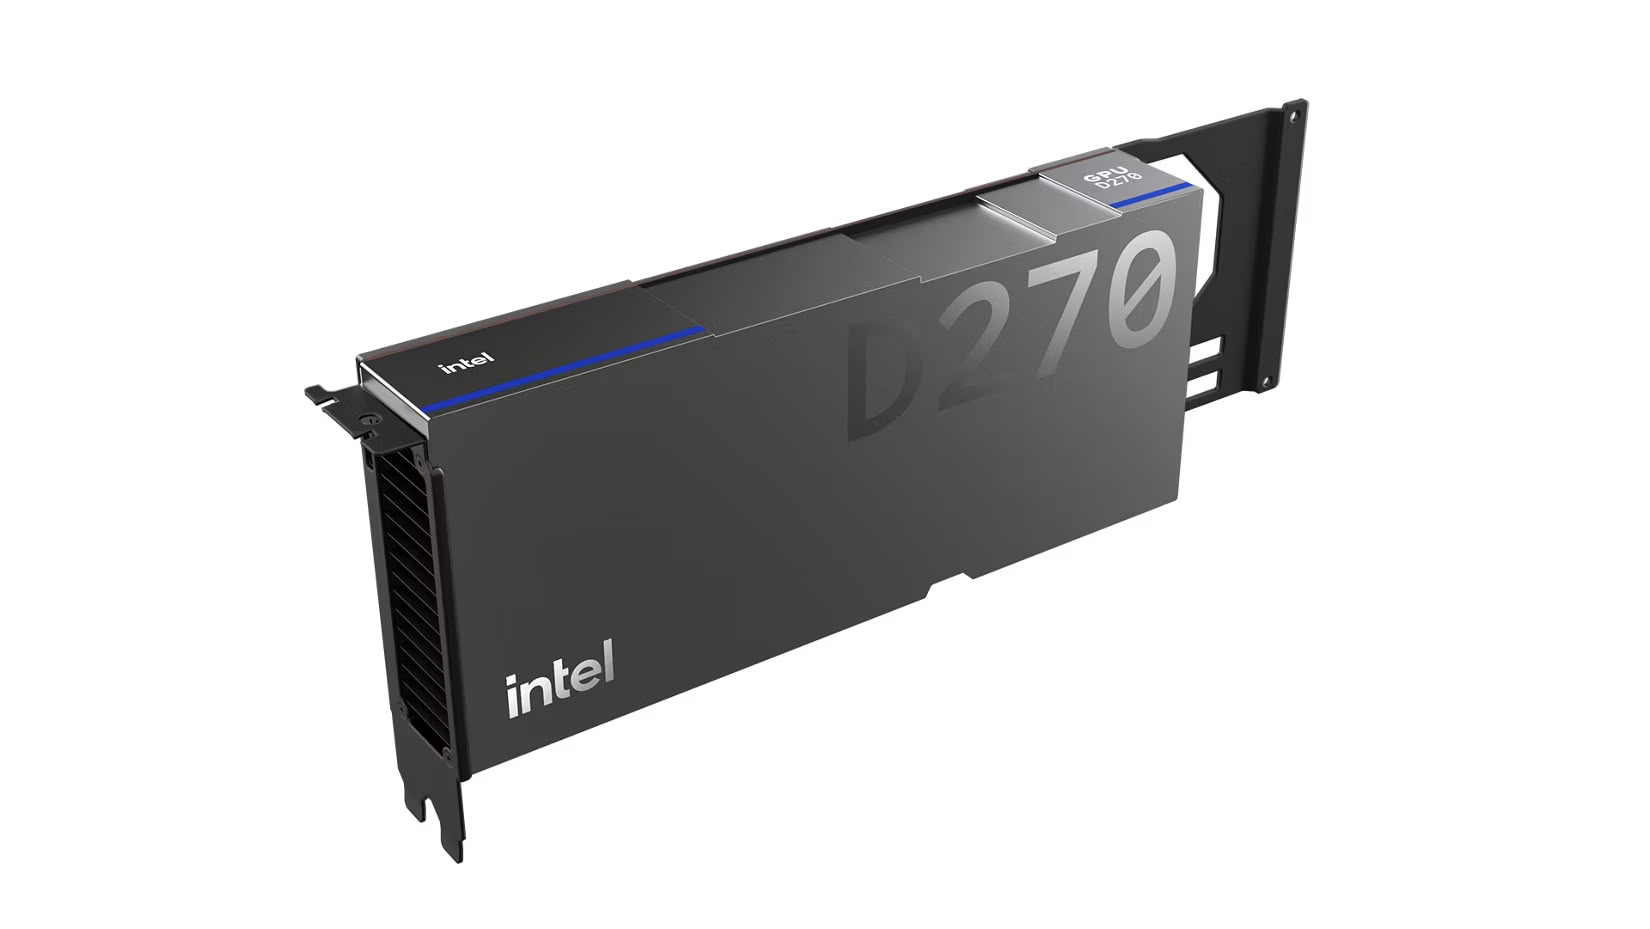
IT时代网10月13日消息,英特尔在今年的开放计算项目全球峰会上,把此前的“Crescent Island”AI 推理加速器正式定名为 GPU D 系列,并公开了最终性能规格,客户送样同步启动。
规格方面,这款加速器集成 32 个 Xe3P 核心、256 个 XMX 矩阵引擎与 256 个矢量引擎,配备 32 MB 统一二级缓存。每个核心拥有 1 MB 寄存器文件与 512 KB 一级缓存,XMX 引擎由 Xe3 上的四级脉动阵列改为十六级结构。
内存配置上,英特尔自有品牌显卡出厂为 160 GB,ODM 客户最高可配到 480 GB LPDDR5X。旗舰型号带宽为 1.5 TB/s,由 20 颗芯片、80 通道的内存总线提供,内存速率约 9375 MT/s。
算力方面,官方给出的 FP8 矩阵峰值性能为 1.3 PFLOPS,数据格式支持范围从 FP4 覆盖到 FP64。作为参照,AMD 同属 PCIe 板卡形态的 MI350P 加速器 FP8 密集矩阵峰值约 2.3 PFLOPS,D 系列低约四成。
产品形态是一块 350 W 风冷 PCIe 5.0 x16 卡,可直接放进常规服务器,无需液冷改造。芯片内部不含图形输出单元,定位是面向长上下文与智能体任务的纯推理负载,同时保留四个编码器与四个解码器组成的媒体引擎,用于视频生成与理解类多模态场景。
按英特尔的说法,单卡可承载 3000 亿参数规模的模型,八卡集群可运行万亿参数模型。软件侧沿用统一的 Xe 软件栈并支持主流 AI 框架,以降低部署门槛。
这是英特尔自 2021 年 Ponte Vecchio 之后的首款商用数据中心 GPU。期间 Rialto Bridge 于 2023 年、Falcon Shores 于 2025 年先后取消,Crescent Island 最初在去年的开放计算项目全球峰会上一并公布,定位是面向推理市场、在成本与功耗上高度优化的过渡产品。
目前价格、正式量产时间与独立第三方性能数据尚未披露。决定这款产品能否与既有 AI 加速平台竞争的关键,仍在于每生成 token 的成本与软件成熟度。
编辑:林一舟