百度披露文心5.5 Flash Base三架构创新

IT时代网11月5日消息,百度今日通过官方公众号披露了昨日开源的文心 5.5 Flash Base 基座模型的技术细节。这一 MoE 架构模型总参数量 2800 亿、每 Token 激活 140 亿参数,此前本站已报道其开源消息(点此回顾),本次官方进一步阐述了围绕「效率」主线的多项架构设计。
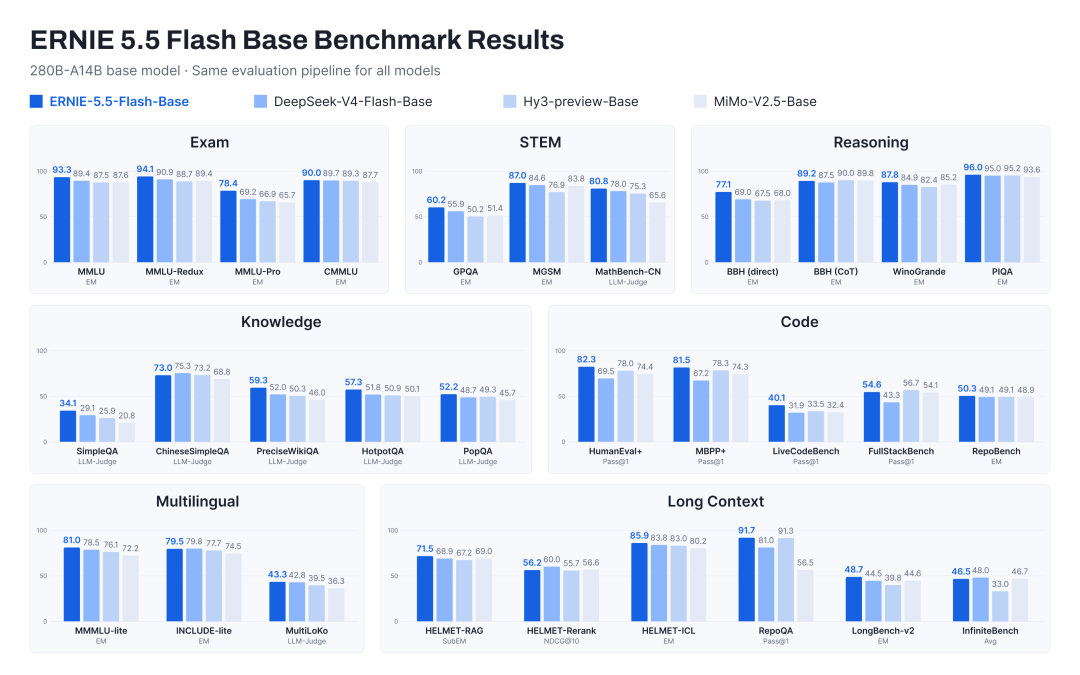
在注意力机制上,文心提出 Latent-Gated Sparse Attention,将混合稀疏注意力、低秩门控注意力与虚拟头注意力结合起来。模型通过组合 HCA 与 MLA,让不同注意力层分别承担压缩历史信息和细粒度访问历史位置的任务;低秩门控注意力改用注意力层本就会生成的低秩 query latent 来计算输出门,门控投影参数量减少 75%,模型效果也有所提升。
虚拟头注意力(VHA)可提升模型表达力与训练质量,推理时融合进注意力算子,开销极小。这些设计降低了长上下文处理的资源开销,同时保留模型对关键信息的处理能力。
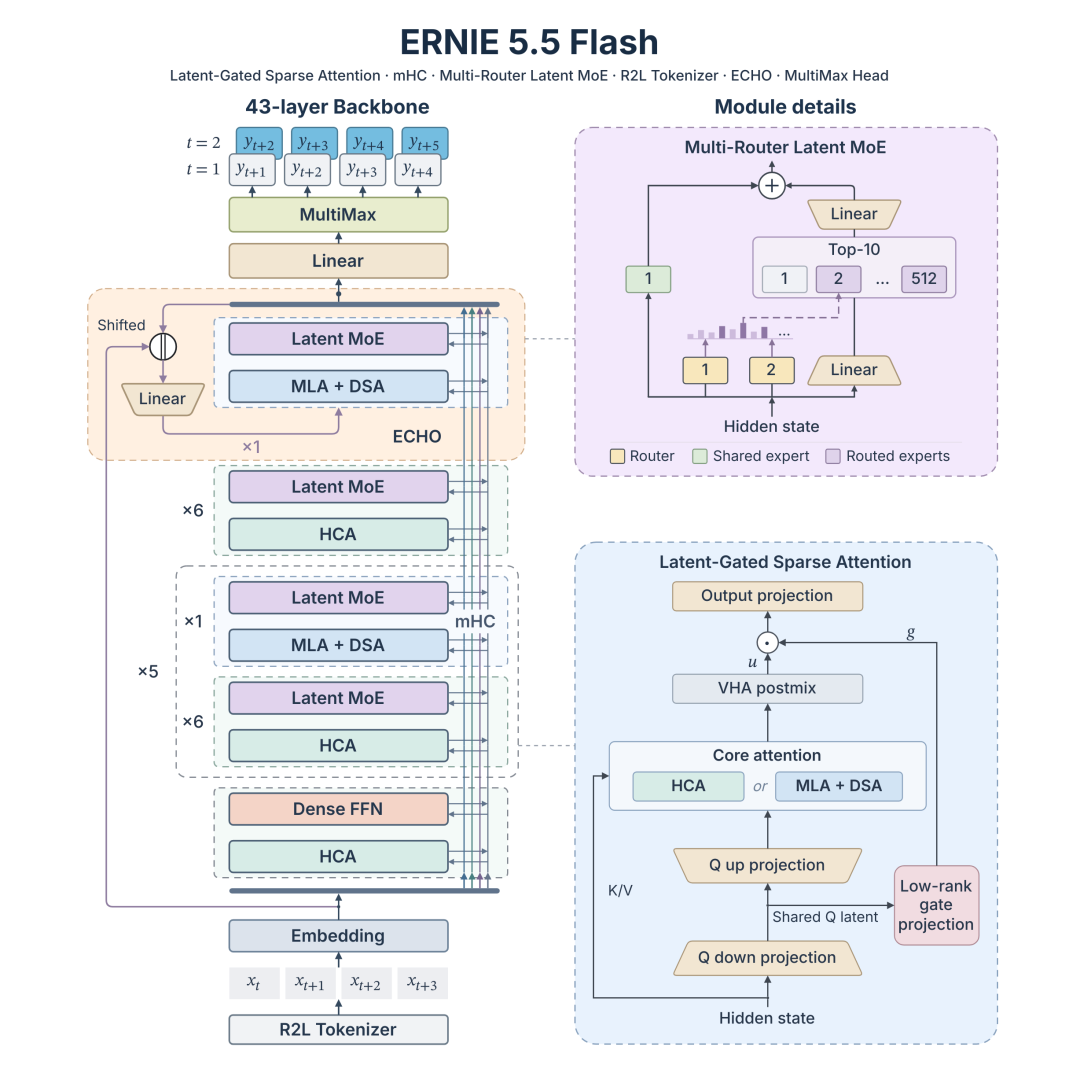
在专家路由上,模型采用 Multi-Router Latent MoE,由多个独立路由器共同参与专家选择,改善路由评分与专家实际效用之间的相关性。相比依赖单一路由器的传统方案,该设计旨在降低单一评分偏差对专家选择的影响,同时保持激活专家数量、专家计算量和通信量不变。
在训练目标上,模型引入 ECHO,无需额外增加 MTP 模块,而是复用主干最后一层,让主干自身学习预测后续 Token,从而提前规划序列走向,有效提升推理与代码能力。文心 5.5 Flash 仅采用单步 ECHO 预训练,复用的最后一层还可作为投机解码的草稿模型,展现出多步外推能力:同样只训练一步,多步起草质量大幅优于辅助 MTP 模块。
除模型架构外,文心改进了分布式 Muon 优化器,并推出面向大 head dim 的注意力算子 FlashMask-4,改善大规模训练中的通信、显存利用与计算效率。官方表示,Base 模型为开发者和企业提供了进一步微调与定制的空间,可基于自身业务需求构建适应不同场景的专业模型与应用。
注:本文封面图由AI生成,正文配图源自百度官方。

