MIT推出AI机器人竞技场评测 GPT-6 Astra夺第一

IT时代网10月11日消息,据Chosun报道,麻省理工学院计算机科学与人工智能实验室(CSAIL)联合纽约大学格罗斯曼医学院、加州大学旧金山分校的研究团队,近日公布一套名为Artifact Arena的大模型评测系统,改用机器人对战的方式衡量人工智能的设计能力。
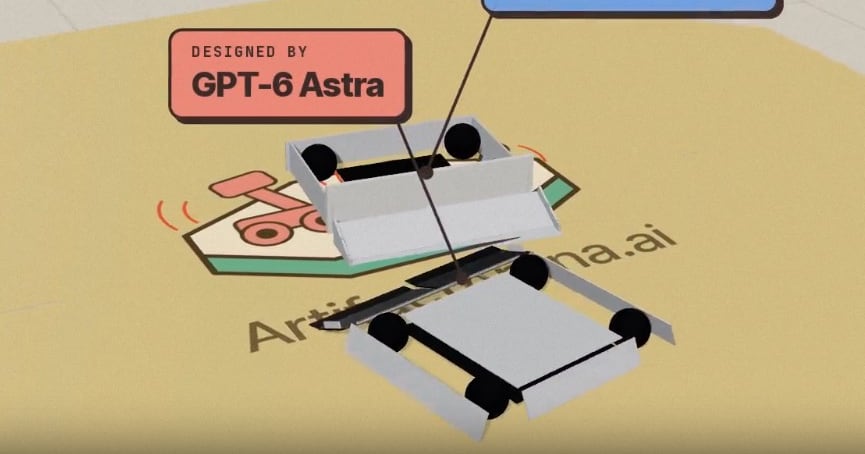
这套系统的测法颇为特殊:由大模型自行设计虚拟机器人,从机身结构到运动控制程序全部交由模型完成,再与其他模型设计的机器人同场较量。竞技场是一个直径15米的圆形场地,把对手推出场外或让其失去行动能力即算获胜。评分不靠人工阅卷,而是依据真实物理引擎的模拟对战结果。
研究团队用这套方法测试了21个大模型,并采用国际象棋常用的Elo积分制排名,击败的对手越强得分越高。各模型给出的方案思路各异:有的设计出楔形机器人从下方拱翻对手,有的加装翻转机构或旋转武器。
实测结果显示,OpenAI的GPT-6 Astra以1539分排在第一,Anthropic的Claude Fable 5.1以1310分列第二,谷歌Gemini 3.8 Flash拿到1223分,Claude Fable 5与GPT-5.4分别以1189分、1179分紧随其后,中国模型Kimi K3以1164分排在第八位。
同一批研究中还包含另外两类实测型评测:OSWorld设置369项任务,考察模型直接操作鼠标键盘完成文件移动、程序运行等端到端能力;卡内基梅隆大学开发的The Agent Company则把模型放进一家虚拟软件公司,要求其完成同事沟通、写代码以及项目、人力、财务与数据分析等事务。
评测方式的转向源于传统题库评测的局限。今年2月,OpenAI停止报告SWE-Bench Verified编码基准的成绩,原因包括题目与答案可能混入训练数据、评测系统误判有效解法等。业界开始更看重模型在陌生场景下解决新问题、产出实际成果的能力,AI评测正从书面考试走向实战考试。
编辑:林一舟